
Ray和KubeRay
本文用于记录学习过程,原文来自第31篇-Ray与KubeRay-弹性分布式计算框架
1、为什么需要 Ray:K8s 之外的第二套调度体系
1.1、训练之外的任务
先看一个真实的 AIaaS 工作流,它远不止「跑一个训练任务」这么简单:
1. 数据预处理:从对象存储拉 10TB 原始文本,分词、去重、清洗
2. 超参搜索:32 组超参并行跑,每组一个轻量训练
3. 强化学习:Policy 模型 + Reward 模型 + 多个 rollout worker 协同
4. 在线学习:推理服务边跑边采集样本,定时增量训练
5. 训推一体:训完一个 checkpoint,立刻起一组推理副本对外服务
这些场景的共同特点是:任务之间有复杂的数据依赖和频繁的中间结果交换。比如超参搜索中,每个 trial 要把 loss 曲线上报给协调器;强化学习中,rollout worker 要把采样数据传给训练 worker。如果用 K8s 原生方式,每一步都得落盘到 PVC 或对象存储再由下一步读取,IO 开销巨大,编排逻辑也极其繁琐。
Ray 的核心价值就在于:它把这些跨任务的通信放进内存,通过一套统一的 Object Store 让任意两个 Task/Actor 之间能以微秒级延迟交换数据,而不需要落盘。
1.2、K8s调度的局限
K8s 是一个面向「长期运行服务」和「批处理任务」的调度器,它的调度粒度是 Pod,调度决策是静态的(Pod 创建时定一次)。这对 Web 服务和无状态批处理很合适,但对 AI 场景有几处力不从心:
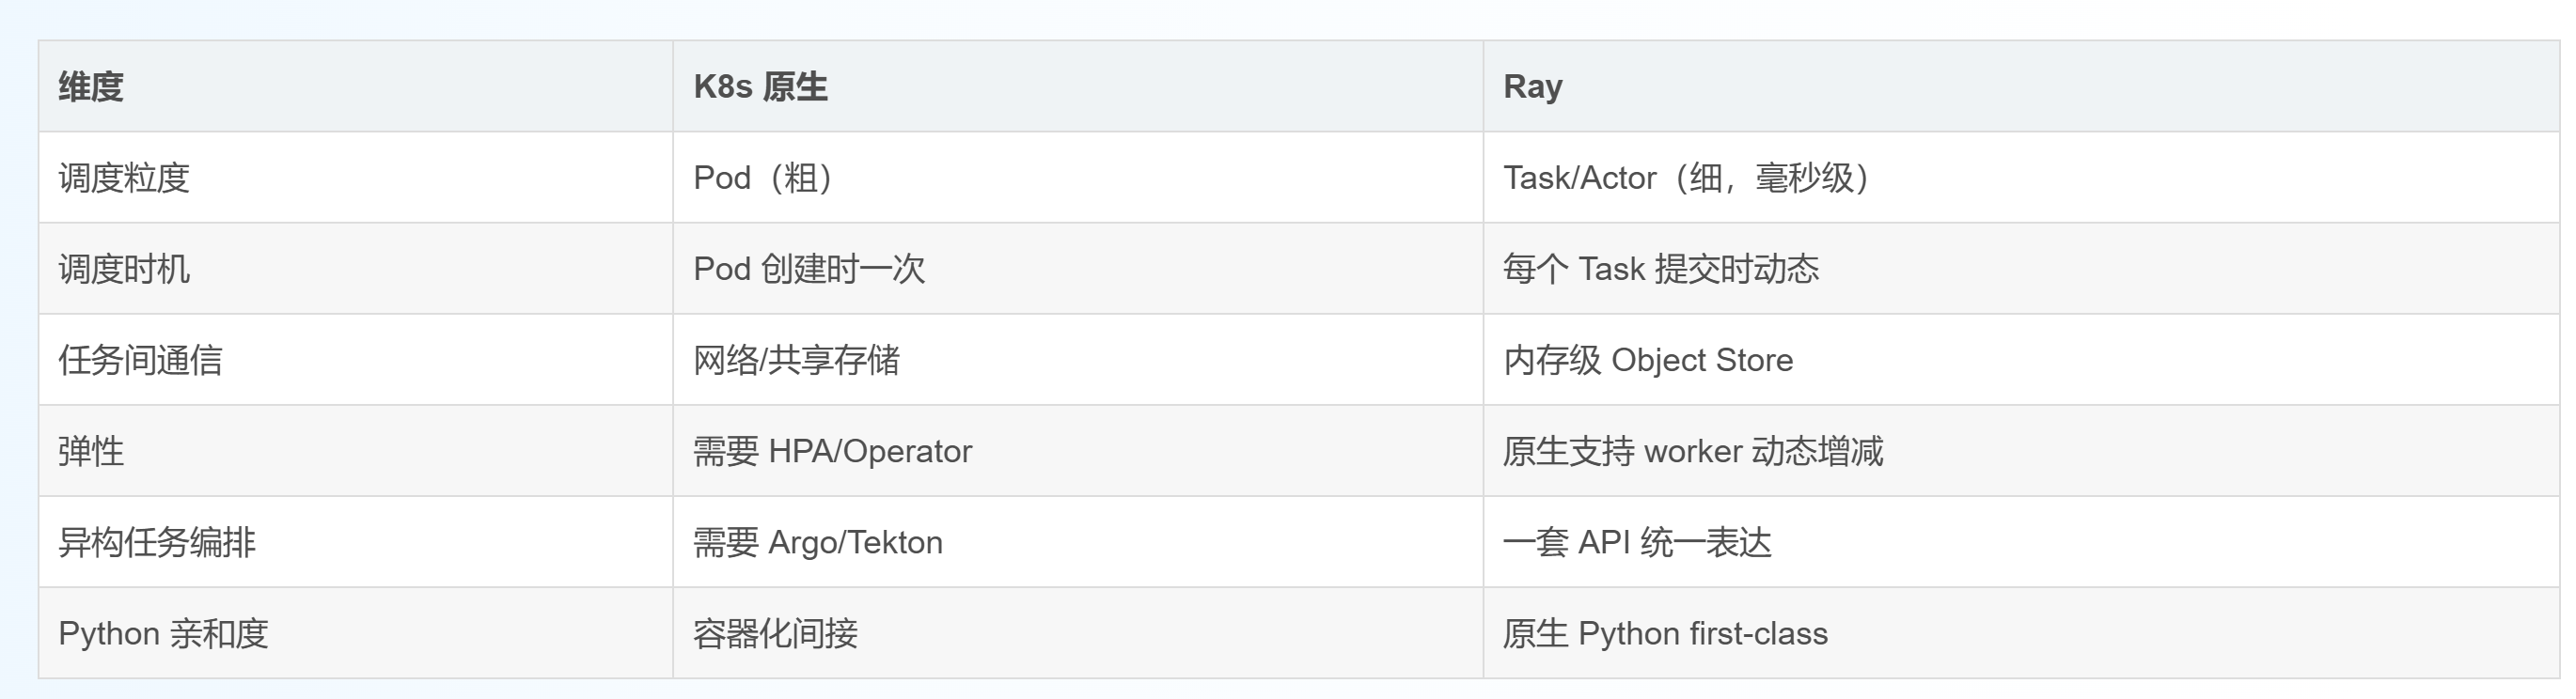
注意,这不是说 Ray 要取代 K8s。Ray 跑在 K8s 之上,K8s 管物理资源,Ray 管计算任务的细粒度调度。二者是分层关系。
1.3、Ray的地位
Ray 在 AI 基础设施栈中的位置可以概括为三层:
分布式计算底座:把单机 Python 函数透明地变成分布式函数。
AI 库的统一运行时:Ray Train(训练)、Ray Serve(推理)、Ray Data(数据处理)、Ray RLlib(强化学习)都构建在 Ray 底座之上。
训推一体化编排:训练完的模型对象可以直接在内存里传给 Serve 部署,无需序列化到磁盘。
理解这三层,才能理解为什么 Ray 在 AI 场景下比 Spark、Flink 更受青睐——后者是为数据工程设计的,而 Ray 是为 AI 工作流量身定做的。
2、Ray 核心架构
2.1、整体架构
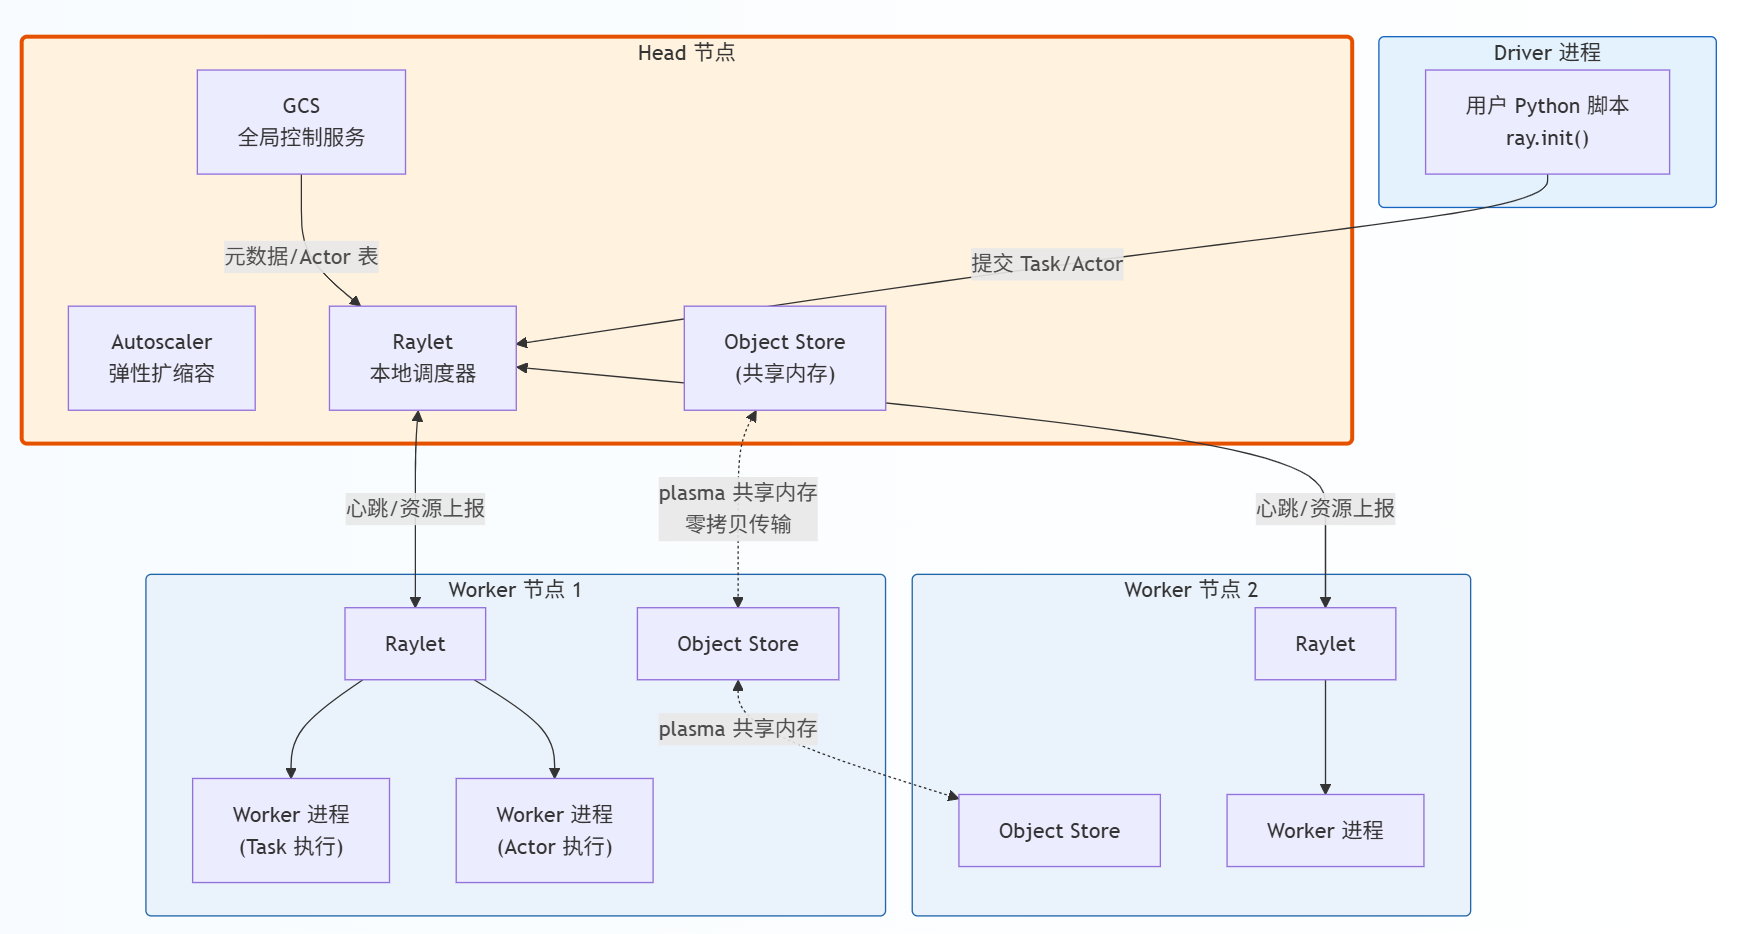
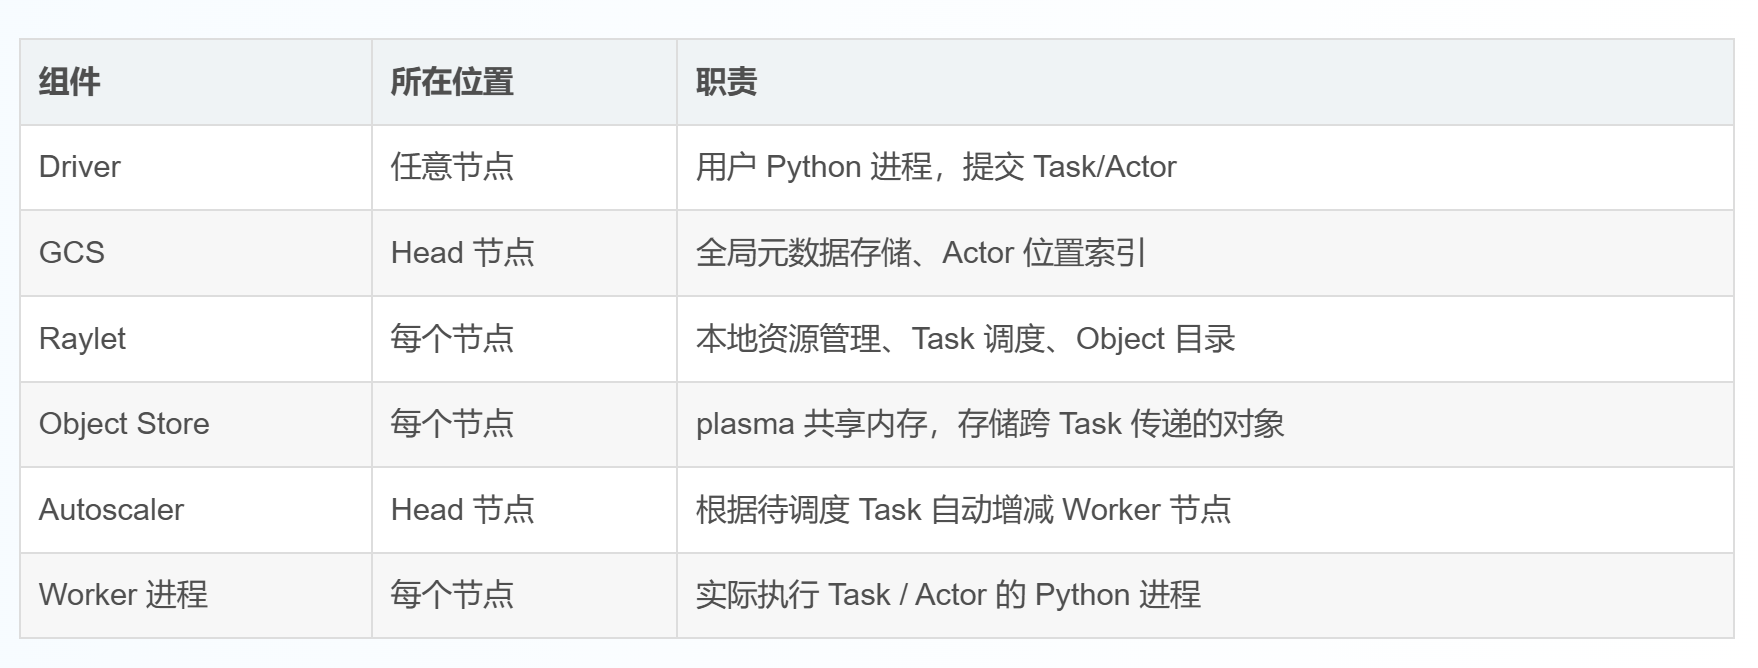
Ray 集群由一个 Head 节点和若干 Worker 节点组成。每个节点上跑着一个 Raylet 进程,它是节点的本地调度器和资源管家。Head 节点额外运行 GCS(Global Control Service),存储集群全局元数据(Actor 表、Placement Group、Actor 位置等)。
2.2、Object Store:内存级数据交换
这是 Ray 区别于其他分布式框架的灵魂设计。每个节点的 Object Store 是一块基于 Apache Arrow plasma 机制的共享内存区域。当一个 Task 产生结果对象时:
对象被序列化写入本节点 Object Store。
Raylet 在 Object Directory 登记这个对象的「位置」。
另一个 Task 引用这个对象时,本地 Object Store 命中就直接读,未命中就从远程节点拉取(TCP + Arrow IPC)。
同一节点内的多个 Worker 进程通过 mmap 共享同一块内存,真正零拷贝。
对比 K8s 方式:两个 Pod 之间传数据,要么共享 PVC(IO 瓶颈),要么走 HTTP/gRPC(序列化开销),延迟差一两个数量级。
2.3、三层编程抽象
Ray 提供三个核心原语,所有上层库都构建其上:
1、Tasks(无状态函数)
首先看 Task。假设你有一个 GPU 集群,里面有 3 台服务器,每台服务器有 2 张 A100。
现在你想在其中一台服务器上执行一次模型训练计算。传统 Python 是这样的:
def train_step(batch):
    loss = model(batch)
    return loss

result = train_step(batch_data)
这里有一个问题:函数在哪里执行?答案是:在当前 Python 进程中执行。
但如果使用 Ray:
@ray.remote(num_cpus=2, num_gpus=1)
def train_step(batch):
    loss = model(batch)
    return loss

future = train_step.remote(batch_data)
这时候发生了什么?
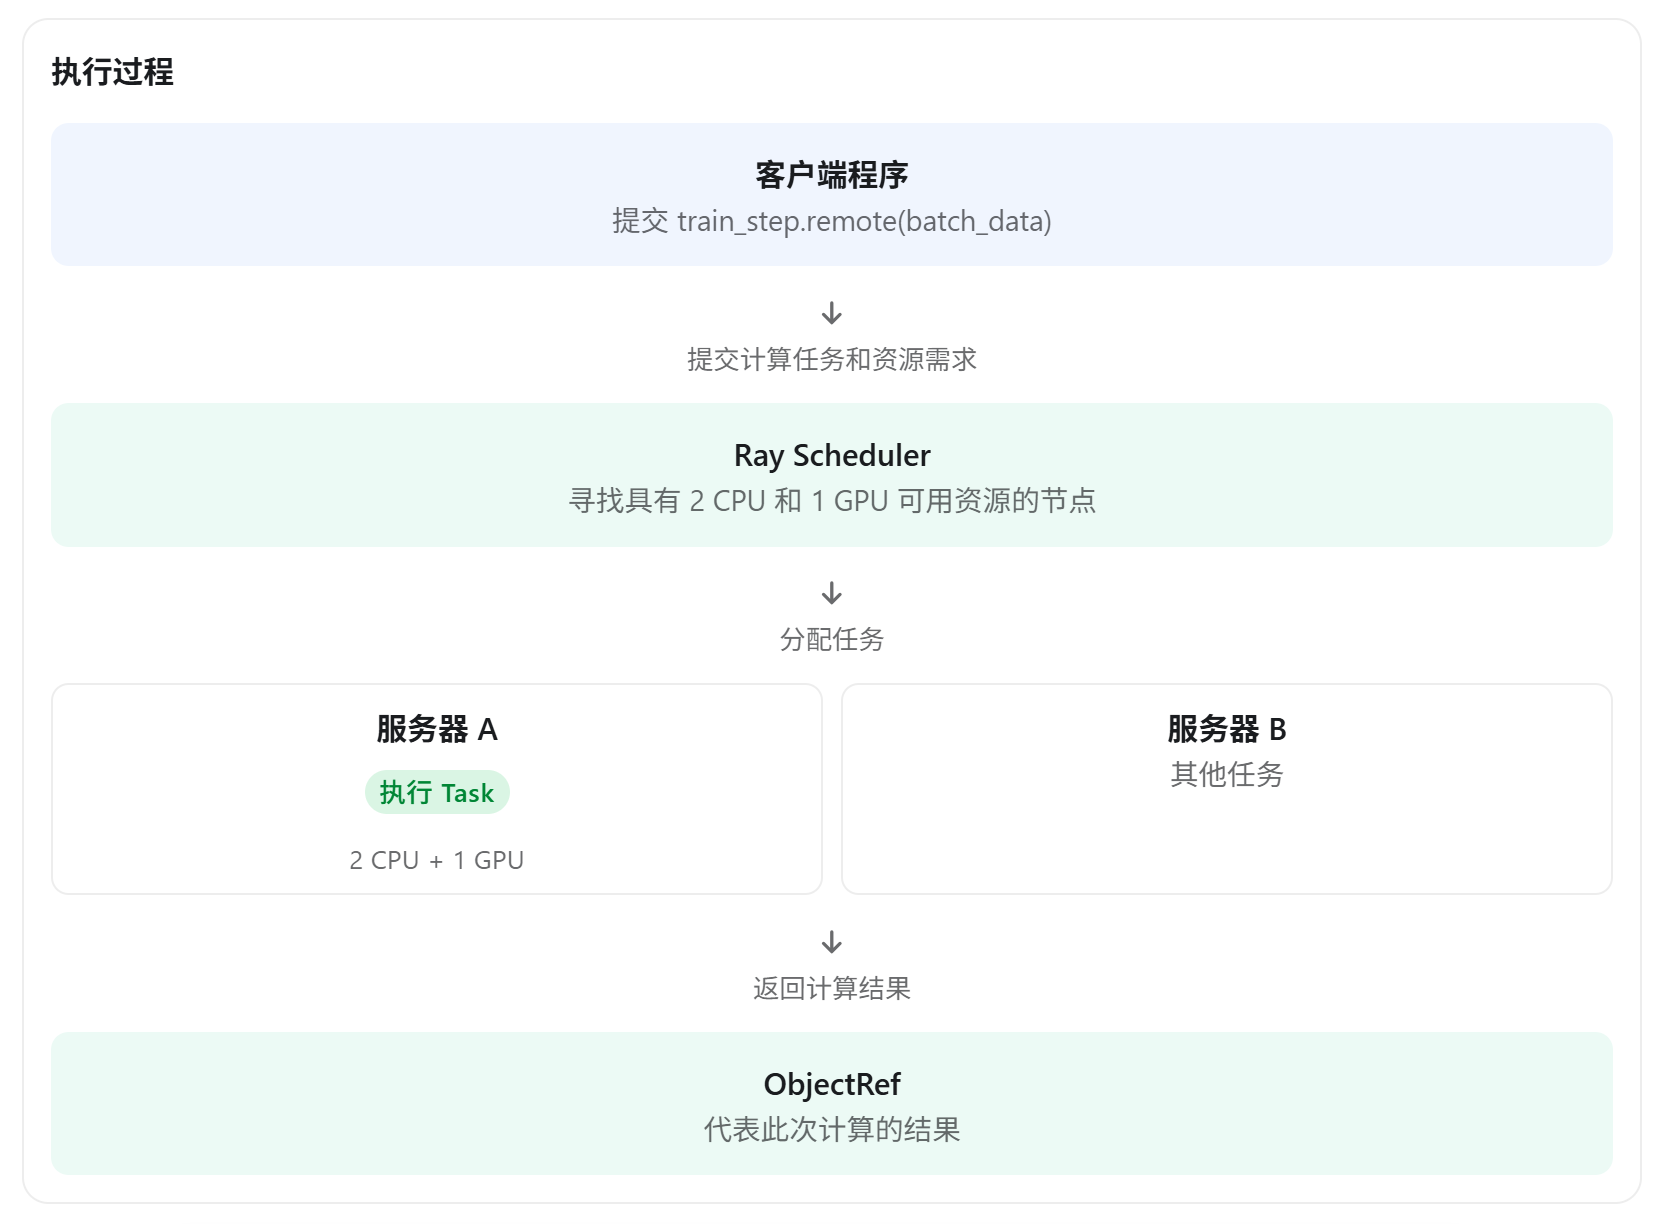
这里最重要的是:
@ray.remote 告诉 Ray:这个函数可以在远程计算节点执行。
train_step.remote() 告诉 Ray:现在提交一次计算任务。
Ray 会根据资源需求,选择合适的 Worker 执行这个函数。
注意,num_cpus=2, num_gpus=1 表示向 Ray 申请相应的逻辑资源,并不意味着你需要自己指定服务器。
所以,Task 本质上就是一次性的远程函数调用。
例如:
执行一次模型训练迭代。
处理一批数据。
执行一次模型评估。
完成一次分布式计算中的数据预处理。
任务执行完毕后,Task 本身就结束了,不会一直驻留在那里。
2、Actors(有状态服务)
接下来是 Actor。这部分非常重要,尤其是对于 AI 推理系统。
假设你想部署一个 LLM 推理服务。你肯定不希望每次收到用户请求,都重新加载一次模型。因为模型可能有几十 GB,加载权重需要消耗大量时间。因此,你希望:
启动一个模型实例。
把模型加载到 GPU 显存。
一直保持模型运行。
不断接收用户请求。
每次请求都调用这个模型进行推理。
这就是 Actor 的典型使用场景。
看代码:
@ray.remote(num_gpus=1)
class ModelServer:

    def __init__(self, model_path):
        self.model = load_model(model_path)

    def infer(self, input):
        return self.model(input)
这里和 Task 最大的区别是:
Task 是一个函数,而 Actor 是一个类的实例。
创建 Actor:
server = ModelServer.remote("/models/llama-8b")这行代码会让 Ray 在某个合适的 Worker 上创建一个 Actor 实例。它会执行 __init__(),把模型加载到 GPU 显存中。
接下来:
out1 = ray.get(server.infer.remote("你好"))
out2 = ray.get(server.infer.remote("今天天气怎么样"))
out3 = ray.get(server.infer.remote("介绍一下 Kubernetes"))
这三次调用都使用同一个 Actor。
这里有一个很关键的概念:Actor 是有状态的(Stateful)。什么叫有状态?
例如:
@ray.remote
class Counter:

    def __init__(self):
        self.count = 0

    def add(self):
        self.count += 1
        return self.count
创建 Actor:
counter = Counter.remote()print(ray.get(counter.add.remote())) # 1
print(ray.get(counter.add.remote())) # 2
print(ray.get(counter.add.remote())) # 3为什么会得到 1、2、3?因为 Actor 内部的 self.count 会一直保留,不会在每次调用时重新初始化。而普通 Task 如果每次执行一个独立函数,就不会天然保留这种实例状态。默认情况下,普通同步 Actor 的方法调用按顺序执行,一次处理一个;Ray 也支持异步 Actor 和并发执行配置。
所以,Actor 本质上就是一个由 Ray 管理的、可以远程调用的长期运行对象。
3、Object Refs(对象引用)
Task 和 Actor 的返回值都是 ObjectRef,它是 Object Store 中对象的句柄。ObjectRef 可以像普通对象一样传递:
# 链式 Task:每一步返回 ref,不落盘
ref1 = step1.remote()
ref2 = step2.remote(ref1)     # step2 会在 ref1 就绪后执行
ref3 = step3.remote(ref2)
final = ray.get(ref3)
Ray 的 DAG 调度器自动分析这些 ref 依赖,构建执行图,并做数据本地性调度。
其实,Ray 的这三个核心原语并不复杂。你可以先记住一句话:
Task:让计算节点帮你执行一次函数。
Actor:让计算节点启动一个长期运行、能够保存状态的对象。
ObjectRef:代表一个计算结果的引用,你可以先拿着它,等结果出来后再获取。
它们分别解决的是:执行计算、维护状态、传递计算结果。
现在我们把三个原语放在一个实际的 LLM 推理场景中。假设你有一个三节点 GPU 集群,需要部署 Llama 推理服务。
可以用下面这个例子理解它们之间的关系:
# 1. 创建一个 Actor,长期运行模型
model = ModelServer.remote("/models/llama")

# 2. 提交一个预处理 Task
data_ref = preprocess.remote(user_input)

# 3. 将预处理结果传给 Actor
result_ref = model.infer.remote(data_ref)

# 4. 获取最终推理结果
result = ray.get(result_ref)
这里:
preprocess是 Task,负责执行一次数据预处理。model是 Actor,负责长期保存模型。data_ref和result_ref是 ObjectRef,负责引用计算结果。
注意,model 本身是 ActorHandle(Actor 的远程调用句柄),而不是 ObjectRef。
Q:
preprocess这不是task吗,是个函数,怎么还有remote方法?
A:对,你理解得没错:
preprocess本身就是一个函数。之所以可以调用.remote(),是因为 Ray 通过@ray.remote装饰器,把普通 Python 函数包装成了一个可以远程执行的对象。1. 普通 Python 函数
def preprocess(data):
    return data.strip()

result = preprocess(" hello ")
这里的
preprocess就是普通函数,只能像普通 Python 函数一样调用:preprocess(data)它会在当前 Python 进程中执行。
2. 使用 Ray 装饰器
import ray

@ray.remote
def preprocess(data):
    return data.strip()
这里发生了变化。
@ray.remote是 Ray 提供的装饰器,它将普通函数包装成一个 RemoteFunction 对象。因此,你可以调用:
result_ref = preprocess.remote(" hello ")注意,这里的
.remote()并不是 Python 函数原本就有的方法,而是 Ray 包装之后提供的接口。此时:
preprocess:Ray 包装后的远程函数对象。
preprocess.remote():向 Ray 提交一次远程计算。
result_ref:返回一个 ObjectRef。3. 为什么 Actor 也有 .remote()?
其实是同样的道理。
@ray.remote
class ModelServer:

    def infer(self, data):
        return data
这里
@ray.remote把普通 Python 类包装成了 Ray 的远程 Actor 类。创建 Actor:
model = ModelServer.remote()调用 Actor 方法:
result_ref = model.infer.remote("hello")这里的
model.infer也不是普通的方法调用,而是 Ray 提供的远程方法调用接口。4. 总结一下
你可以记住一个规律:
在 Ray 中,经过
@ray.remote包装的函数和类,才具有.remote()这个远程执行接口。所以,Ray 并没有改变 Python 函数本身的语法,而是在 Python 原有的函数和类之上,增加了一层分布式执行能力。
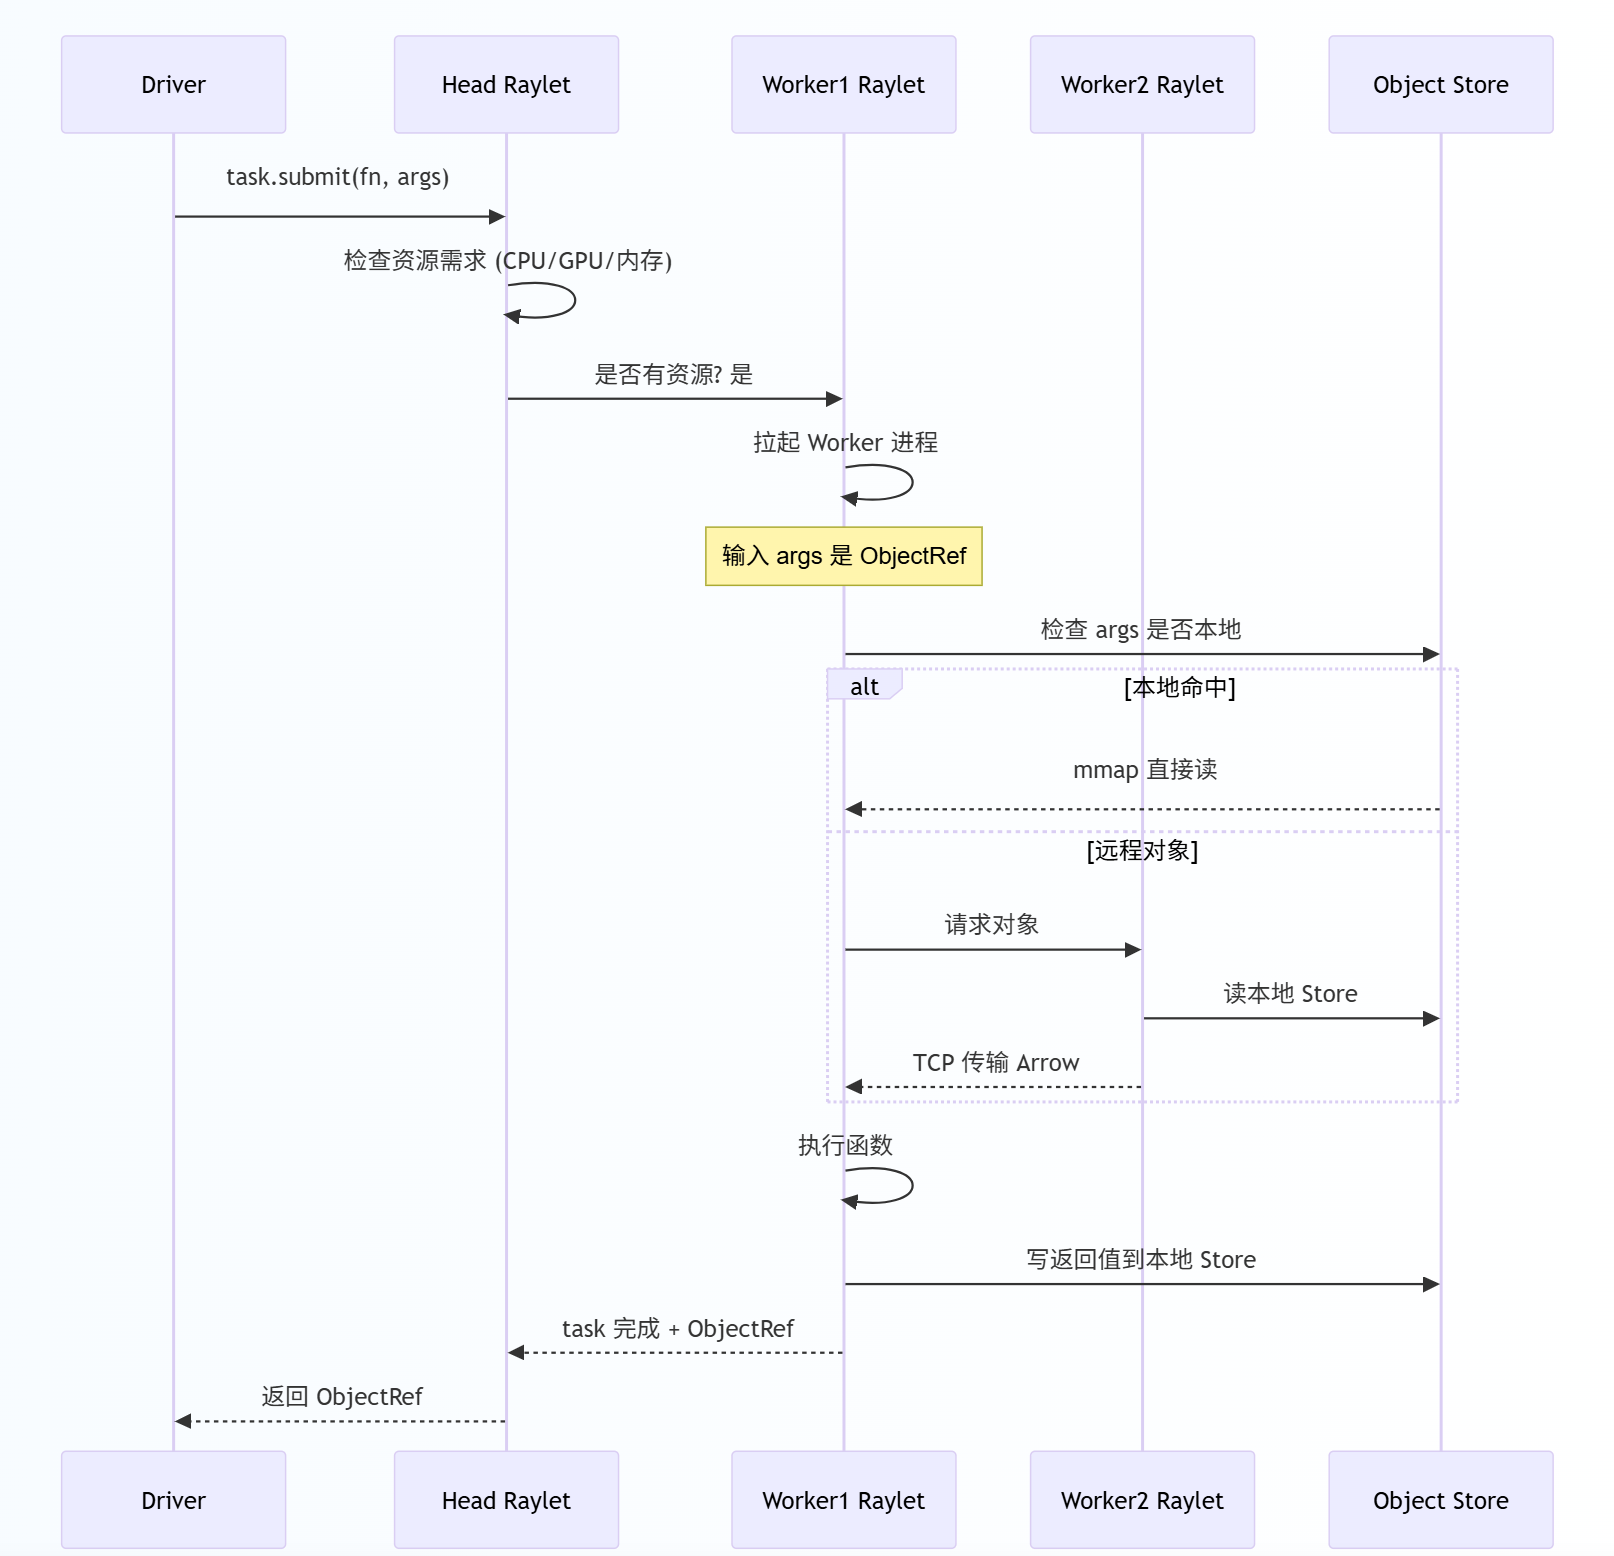
2.4、任务调度流程
这个调度流程的几个关键点:
数据本地性优先:调度器优先把 Task 发到输入对象所在的节点,避免跨节点传输。
资源感知:Task 声明的 CPU/GPU 需求,Raylet 按 Worker 节点的可用资源匹配。
零拷贝:同节点 Worker 间共享内存,不经过序列化。
拓扑感知:通过 Placement Group 可以约束一组 Actor 跑在相邻节点(NVLink 域内),这对分布式训练至关重要。
3、Ray Train:分布式训练
3.1、Ray Train 的定位
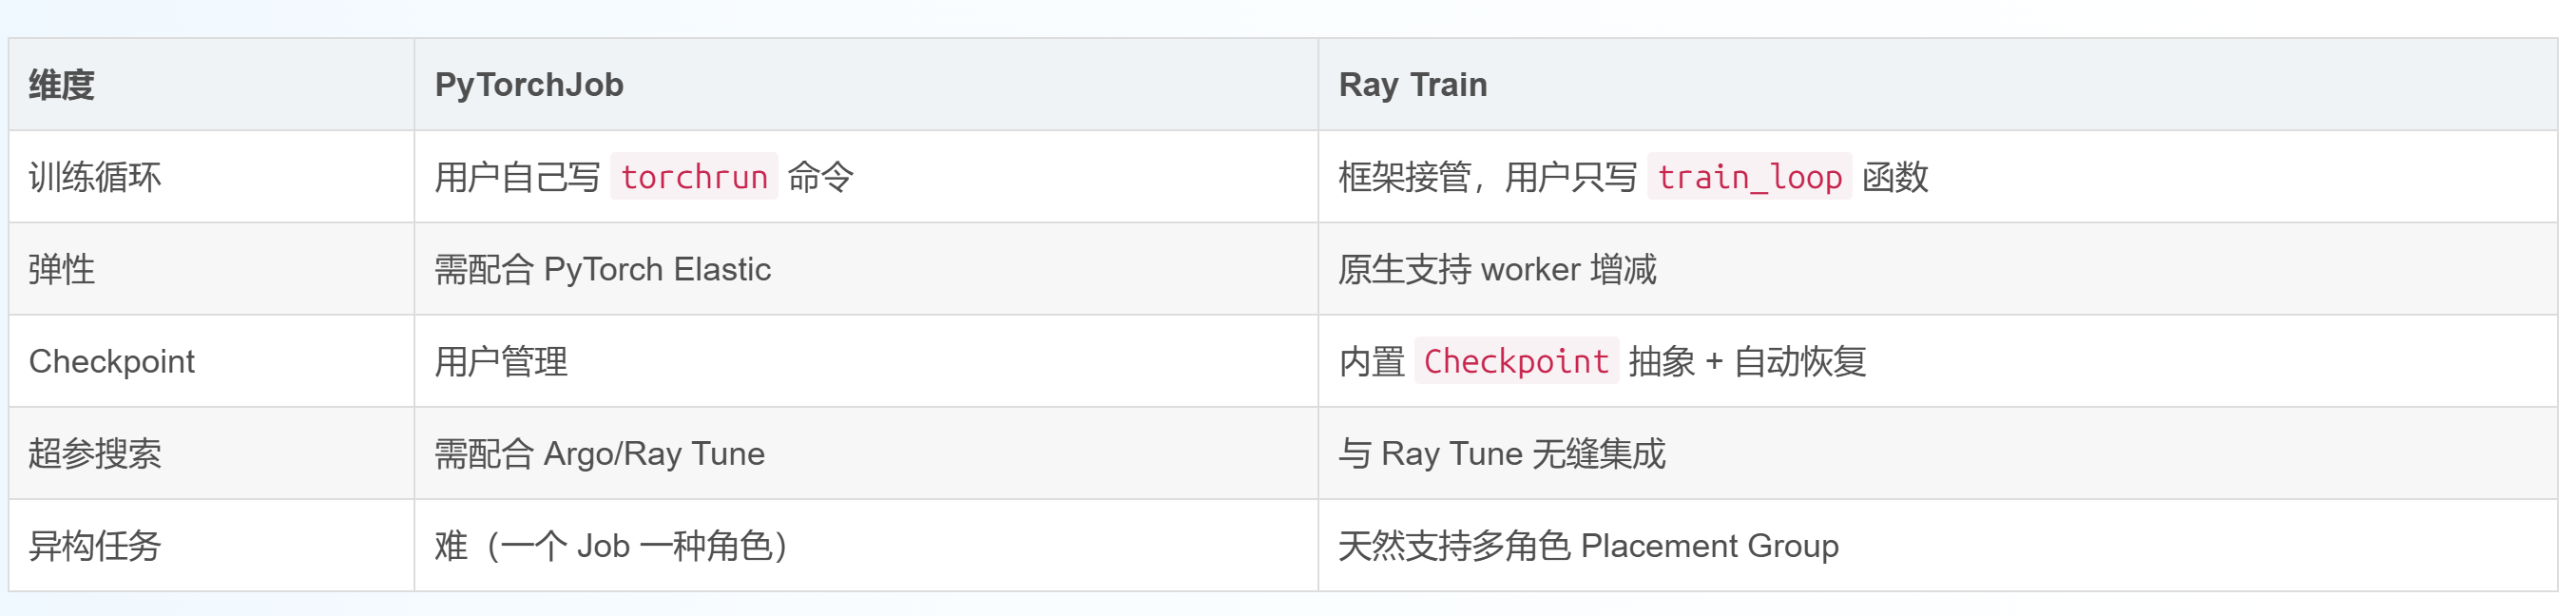
Ray Train 是 Ray 生态里负责分布式训练的高层库。它底层封装了 PyTorch DDP / Horovod / TensorFlow 的分布式策略,上层提供统一的 Python API。与 PyTorchJob(Training Operator)相比:
3.2、一个完整的 Ray Train 示例
import torch
import torch.nn as nn
from ray import train
from ray.train import Checkpoint, ScalingConfig
from ray.train.torch import TorchTrainer

def train_loop_per_worker(config):
    # 自动注入的分布式上下文
    rank = train.get_context().get_world_rank()
    world_size = train.get_context().get_world_size()
    local_rank = train.get_context().get_local_rank()

    model = nn.Linear(784, 10).cuda(local_rank)
    model = nn.parallel.DistributedDataParallel(
        model, device_ids=[local_rank]
    )
    optimizer = torch.optim.Adam(model.parameters(), lr=config["lr"])

    for epoch in range(config["epochs"]):
        for batch in dataloader:
            loss = train_step(model, batch, optimizer)

        # Checkpoint 由框架自动同步到所有 worker
        if rank == 0:
            train.report(
                {"loss": loss.item()},
                checkpoint=Checkpoint.from_dict(
                    {"model": model.state_dict(), "epoch": epoch}
                ),
            )

# 声明资源:4 个 worker,每个 1 GPU
scaling_config = ScalingConfig(num_workers=4, use_gpu=True)

# 可选:Placement Group 约束拓扑
trainer = TorchTrainer(
    train_loop_per_worker,
    train_loop_config={"lr": 1e-4, "epochs": 10},
    scaling_config=scaling_config,
)
result = trainer.fit()
print(result.metrics)
print(result.checkpoint)   # 可直接传给 Ray Serve
注意几个关键设计:
train_loop_per_worker 是每个 worker 进程都会执行的函数,框架在内部帮你做了 init_process_group、DistributedSampler、梯度同步。
train.report 同时上报指标和 checkpoint,框架保证只有 rank 0 的 checkpoint 被持久化。
ScalingConfig 声明资源,底层映射到 Placement Group,实现拓扑感知调度。
result.checkpoint 是 Python 对象,可以直接传给 Ray Serve 部署,这是训推一体化的关键。
4、Ray Serve:推理服务
4.1、从训练到推理的无缝衔接
Ray Serve 是 Ray 的推理服务框架。它最大的特点是与 Ray Train 共享同一套 Object Store,训练完的模型对象可以直接传给 Serve 部署,无需序列化落盘:
from ray import serve
import ray

# 训练阶段
trainer = TorchTrainer(train_loop_per_worker, ...)
result = trainer.fit()
checkpoint = result.checkpoint   # Python 对象

# 推理阶段:同一进程内衔接
@serve.deployment(
    ray_actor_options={"num_gpus": 1},
    autoscaling_config={"min_replicas": 1, "max_replicas": 8},
)
class LlamaServer:
    def __init__(self, ckpt):
        self.model = load_from_checkpoint(ckpt)
    async def __call__(self, request):
        return self.model.generate(request.prompt)

# 部署,checkpoint 直接传入,无落盘
app = LlamaServer.bind(checkpoint)
serve.run(app, route_prefix="/v1")
这在「持续训练 → 灰度发布 → 全量切换」的闭环里价值巨大。模型权重永远不离开 Ray 集群内存,避免了从 PVC/S3 反复加载的几十秒延迟。
4.2、Deployment 与 Replica
Ray Serve 的核心抽象是 Deployment(一组同名推理副本)。一个 Deployment 由多个 Replica(Ray Actor)组成,每个 Replica 是一个常驻进程,加载一份模型权重:
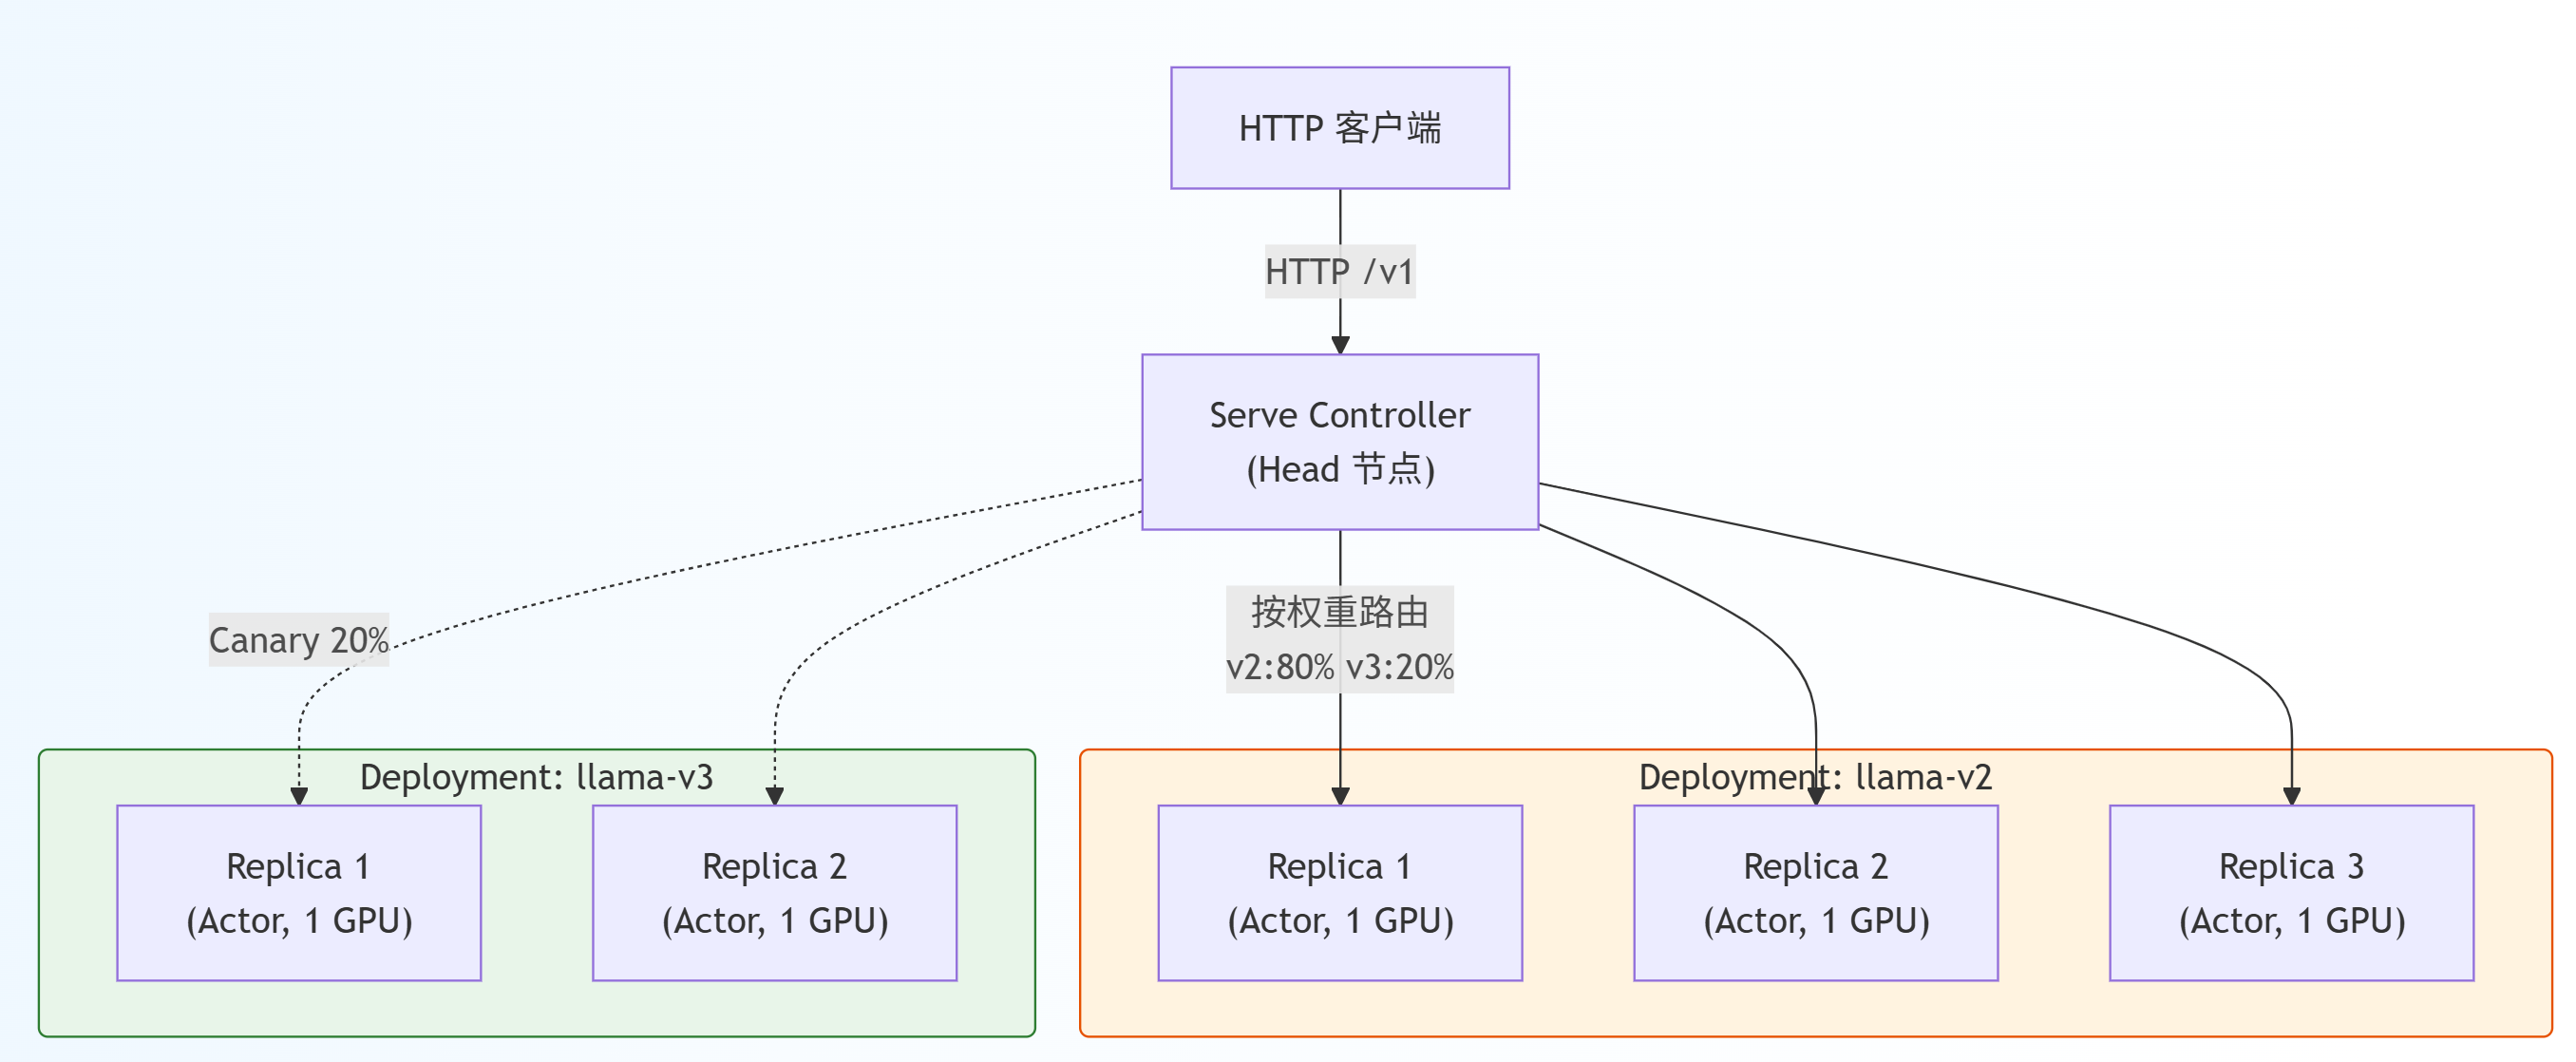
Serve Controller 是一个常驻 Actor,负责:
接收 HTTP/gRPC 请求,按路由规则分发到对应 Deployment。
在 Deployment 内部按权重(Canary)和负载均衡策略选 Replica。
监控 Replica 健康,自动重启失败的 Actor。
根据 QPS/GPU 利用率触发 Autoscaler 调整 Replica 数。
4.3、自动扩缩容
Ray Serve 内置 Autoscaler,无需借助 HPA:
@serve.deployment(
    autoscaling_config={
        "target_num_ongoing_requests_per_replica": 10,  # 每副本理想并发
        "min_replicas": 2,
        "max_replicas": 32,
        "upscale_delay_s": 30,        # 扩容冷却 30s
        "downscale_delay_s": 300,     # 缩容冷却 5min
    },
)
class LlamaServer:
    ...
扩缩容逻辑:
每秒采集每个 Replica 的在途请求数。
如果平均在途 > target,则扩容:新副本数 = ceil(当前并发 / target)。
如果平均在途 < target 且持续 downscale_delay_s,则缩容。
副本数受 [min_replicas, max_replicas] 约束。
这套逻辑比 K8s HPA(基于 CPU/QPS 阈值)更适合推理场景,因为它直接针对「每个模型副本的并发度」这个推理服务的核心 SLA 指标。
4.4、多模型编排:Deployment Graph
复杂推理场景(多模型流水线、级联、路由)可以用 Ray Serve 的 Deployment Graph 表达:
from ray import serve
from ray.serve.dag import InputNode
from ray.serve.drivers import DAGDriver

@serve.deployment
class Classifier:
    async def __call__(self, text):
        return classify(text)   # 返回类别

@serve.deployment
class DomainExpertA:
    async def __call__(self, text):
        return generate_a(text)

@serve.deployment
class DomainExpertB:
    async def __call__(self, text):
        return generate_b(text)

@serve.deployment
class Router:
    def __init__(self, a, b):
        self.a, self.b = a, b
    async def __call__(self, text, cls):
        expert = self.a if cls == "A" else self.b
        return await expert(text)

with InputNode() as user_input:
    cls = Classifier.bind().__call__(user_input)
    out = Router.bind(DomainExpertA.bind(), DomainExpertB.bind()).__call__(
        user_input, cls
    )

app = DAGDriver.bind(out)
serve.run(app)
这个 Graph 会先跑 Classifier,根据分类结果路由到不同的领域专家模型。Ray Serve 自动做依赖调度,Classifier 和 DomainExpert 可以分布在不同节点,中间通过 Object Store 传递。
5、KubeRay
5.1、为什么需要 KubeRay
Ray 自身有 Autoscaler,可以管理 EC2/裸机集群。但在 K8s 已经是基础设施标准的前提下,把 Ray 集群也变成 K8s 声明式管理的对象有明显好处:
Ray 集群生命周期(创建、扩缩容、销毁)纳入 GitOps。
复用 K8s 的 RBAC、NetworkPolicy、Service Mesh。
与 Kueue/Volcano 等批调度器协同管理 GPU 配额。
多租户隔离:每个团队一个 RayCluster CR,互不干扰。
KubeRay 就是这个 CRD Operator。它定义了两个核心 CRD:RayCluster(管理一个常驻 Ray 集群)和 RayJob(提交一次性 Ray 任务)。
5.2、RayCluster CRD 详解
一个完整的 RayCluster 定义:
apiVersion: ray.io/v1
kind: RayCluster
metadata:
  name: llm-training-cluster
  namespace: ray
spec:
  rayVersion: '2.30.0'
  headGroupSpec:
    serviceType: ClusterIP
    template:
      spec:
        containers:
          - name: ray-head
            image: rayproject/ray:2.30.0-py310-gpu
            resources:
              limits:
                cpu: "8"
                memory: 32Gi
            ports:
              - containerPort: 6379   # Redis
              - containerPort: 8265   # Dashboard
              - containerPort: 10001  # Client
            volumeMounts:
              - name: shared-mem
                mountPath: /dev/shm
        volumes:
          - name: shared-mem
            emptyDir:
              medium: Memory
              sizeLimit: 16Gi         # Object Store 内存上限
  workerGroupSpecs:
    - replicas: 4
      minReplicas: 2
      maxReplicas: 16                 # Autoscaler 上限
      groupName: gpu-workers
      rayStartParams: {}
      template:
        spec:
          schedulerName: volcano       # 可对接 Volcano Gang Scheduling
          containers:
            - name: ray-worker
              image: rayproject/ray:2.30.0-py310-gpu
              resources:
                limits:
                  nvidia.com/gpu: 8
                  cpu: "64"
                  memory: 256Gi
              volumeMounts:
                - name: shared-mem
                  mountPath: /dev/shm
                - name: dshm
                  mountPath: /dev/shm
          volumes:
            - name: dshm
              emptyDir:
                medium: Memory
                sizeLimit: 64Gi
          nodeSelector:
            nvidia.com/gpu.product: A100-SXM4-80GB
关键字段:
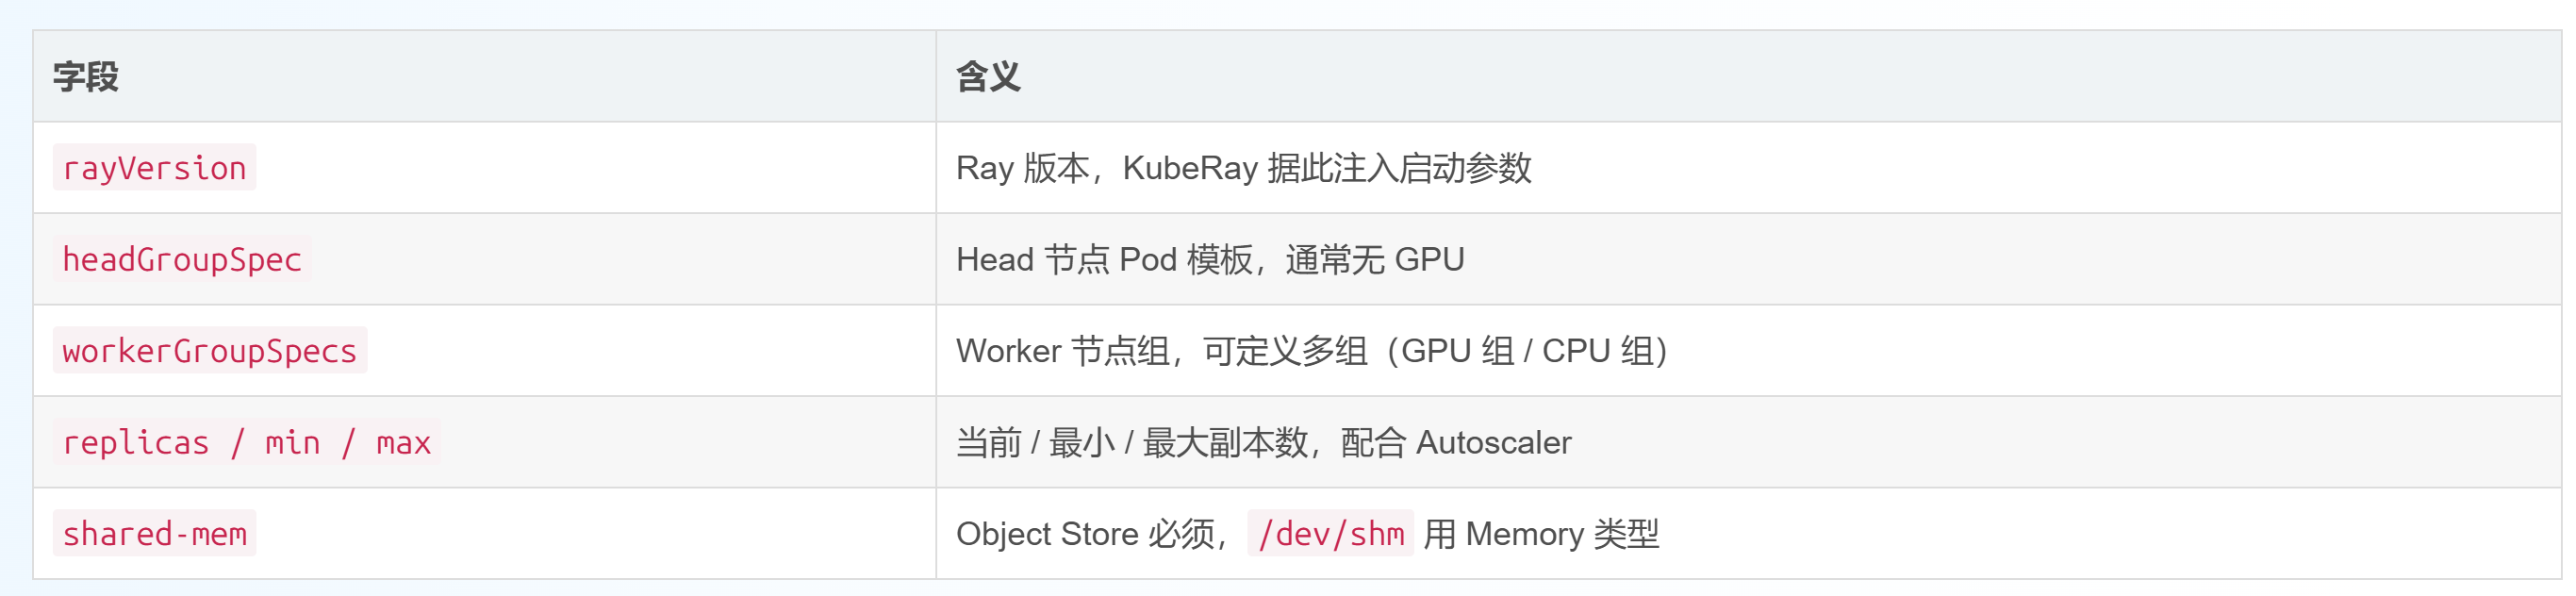
这是最基础的一个 CRD。
假设你现在有一个 Kubernetes 集群:
Node 1:8 张 A100
Node 2:8 张 A100
Node 3:8 张 A100
Node 4:8 张 A100
你希望把这 4 台服务器组成一个 Ray 集群。
那么你就可以创建一个
RayCluster。1. 创建之后会发生什么?
你提交:
kubectl apply -f raycluster.yaml
KubeRay Operator 读取 RayCluster 配置,然后创建:
1 个 Head Pod。
4 个 Worker Pod。
这里要区分:
Head Pod:相当于 Ray 集群的协调节点。
Worker Pod:提供实际的计算资源,执行 Task 和 Actor。
注意,Head Pod 不是 Kubernetes 的 Master Node。它只是 Ray 集群自己的 Head Node。
3. RayCluster 创建后能干什么?这时候你已经有了一个可用的 Ray 计算集群。
你可以向它提交不同的计算任务:
2. RayCluster 创建后能干什么?
这时候你已经有了一个可用的 Ray 计算集群。
你可以向它提交不同的计算任务:
@ray.remote
def task1():
    return "training"

@ray.remote
def task2():
    return "inference"

a = task1.remote()
b = task2.remote()
这些 Task 可以由 Ray 调度到不同的 Worker 上执行。
所以:
RayCluster 只负责提供一个可用的 Ray 集群,本身并不规定你要运行什么程序。
你可以在这个集群上反复提交训练任务、推理任务或者其他分布式计算任务。
这也是为什么 RayCluster 适合常驻集群和开发测试环境。
5.3、弹性扩缩容
Ray 的 Autoscaler 与 K8s 原生 HPA 是两套机制。Ray 的扩缩容基于 待调度 Task 队列长度:
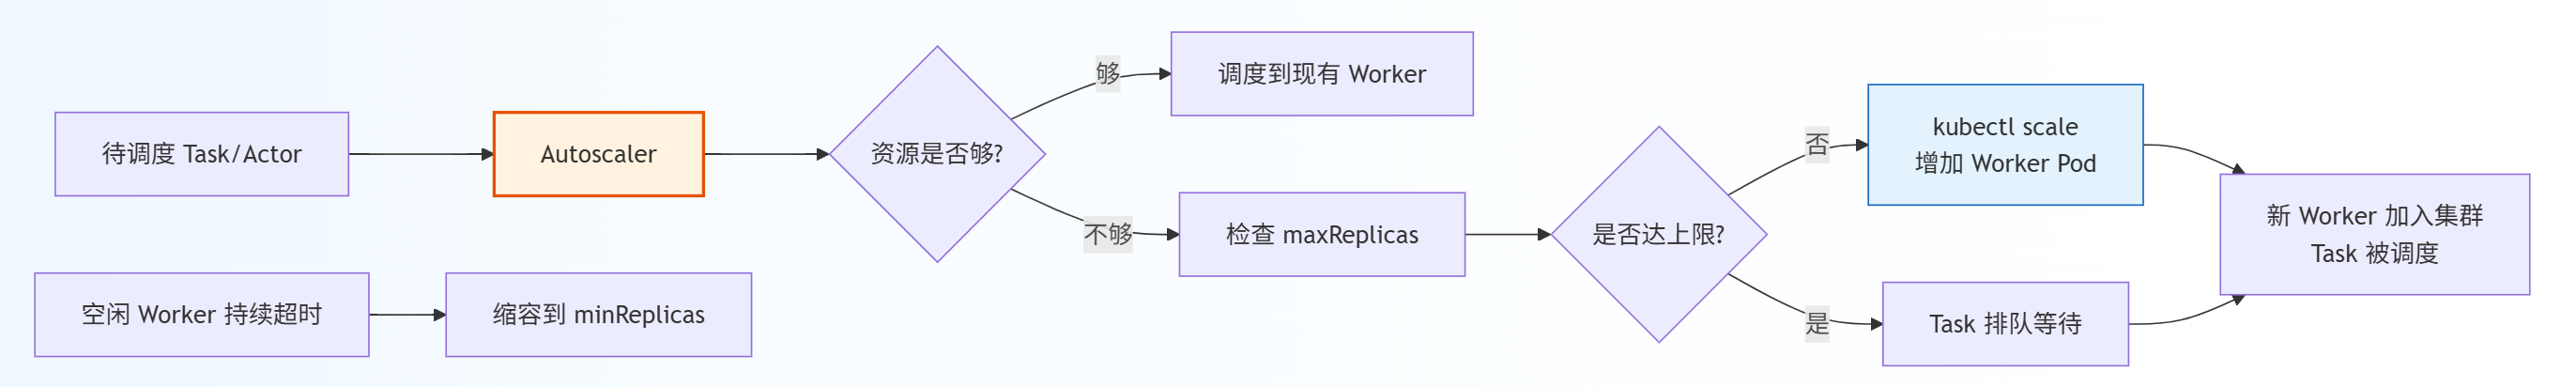
这与 K8s HPA 的关键区别:Ray Autoscaler 看的是「Ray 内部」的资源需求(Task 队列),而 HPA 看的是「Pod 外部」的 CPU/QPS 指标。对于 Ray 场景,前者更精准——它直接知道有多少 Task 在等 GPU。
5.4、RayJob:一次性任务
如果是跑完即销的训练任务,用 RayJob 更合适:
apiVersion: ray.io/v1
kind: RayJob
metadata:
  name: hyperparam-search
  namespace: ray
spec:
  submissionMode: K8sJobMode
  entrypoint: python tune_search.py --trials 32
  runtimeEnvYAML: |
    pip:
      - optuna==3.6.0
      - transformers==4.42.0
    env_vars:
      NCCL_DEBUG: WARN
  rayClusterSpec:
    rayVersion: '2.30.0'
    headGroupSpec:
      template:
        spec:
          containers:
            - name: ray-head
              image: rayproject/ray:2.30.0-py310-gpu
              resources:
                limits:
                  cpu: "4"
                  memory: 16Gi
    workerGroupSpecs:
      - replicas: 4
        minReplicas: 0
        maxReplicas: 8
        groupName: gpu
        template:
          spec:
            containers:
              - name: ray-worker
                image: rayproject/ray:2.30.0-py310-gpu
                resources:
                  limits:
                    nvidia.com/gpu: 4
  shutdownAfterJobFinishes: true
  ttlSecondsAfterFinished: 3600
RayJob 的特点:
submissionMode: K8sJobMode 表示用 K8s Job 提交 entrypoint 到 Ray 集群。
runtimeEnvYAML 声明运行时依赖(pip 包、env vars、工作目录),Ray 自动在所有 Worker 上准备。
shutdownAfterJobFinishes: true 任务完成后销毁集群,释放 GPU。
ttlSecondsAfterFinished 控制清理延迟,便于事后查日志。
这种「按需起集群 + 跑完即销」的模式,比常驻 Training Operator 集群更节省 GPU 成本,尤其适合超参搜索这类间歇性任务。
假设你有一个训练需求:
使用 32 张 A100 训练一个 Llama 模型
训练 10 个 Epoch
训练完成后保存模型
然后释放 GPU
你不需要一直保留一个 Ray 集群。
你希望:
需要训练时,自动创建 Ray 集群。
集群创建完成后,自动提交训练程序。
训练结束后,自动销毁 Ray 集群。
释放 GPU 资源。
这就是
RayJob的典型应用场景。1. RayJob 和 RayCluster 有什么区别?
RayCluster 是:我要一个 Ray 集群,之后可以在里面运行各种任务。
RayJob 是:我要执行一次 Ray 任务,请帮我准备集群、提交程序,并在任务完成后进行清理。
你可以理解为:
RayCluster 管理的是计算环境。
RayJob 管理的是一次计算任务及其运行生命周期。
2. RayJob 实际执行过程
apiVersion: ray.io/v1
kind: RayJob
metadata:
  name: llama-training
spec:
  submissionMode: K8sJobMode

  entrypoint: python train.py

  rayClusterSpec:
    rayVersion: "2.30.0"
    headGroupSpec:
      # Head Pod 配置
      ...
    workerGroupSpecs:
      - replicas: 4
        groupName: gpu
        template:
          # GPU Worker Pod 配置
          ...

  shutdownAfterJobFinishes: true
  ttlSecondsAfterFinished: 3600
提交 RayJob
kubectl apply -f rayjob.yaml
KubeRay 创建 RayCluster
根据 rayClusterSpec 创建 Head Pod 和 Worker Pod
第三步:创建 Kubernetes Job
运行提交程序,将 train.py 提交给 Ray 集群
第四步:Ray Worker 执行训练
实际计算发生在 Ray 集群的 Worker 上
第五步:训练完成
返回任务状态,保存训练结果
删除 RayCluster
按照清理策略释放 GPU 资源
这里有一个很容易混淆的地方:
RayJob 内部实际上涉及两种不同的 Job。
第一种:Kubernetes Job。它是 KubeRay 创建的提交器,负责把训练程序提交到 Ray 集群。
第二种:Ray Job。它是实际提交给 Ray 集群运行的应用程序,例如:python train.py
5.5、RayService:训推一体化
RayService CRD 把「Ray 集群 + Serve 推理服务」打包成一个对象:
apiVersion: ray.io/v1
kind: RayService
metadata:
  name: llm-serving
spec:
  serveConfigV2: |
    applications:
      - name: llama-serve
        import_path: mod:app
        route_prefix: /v1
        deployments:
          - name: LlamaServer
            num_replicas: 4
            ray_actor_options:
              num_gpus: 1
            autoscaling_config:
              min_replicas: 2
              max_replicas: 16
  rayClusterConfig:
    rayVersion: '2.30.0'
    # ... 与 RayCluster 相同
RayService 会自动:
起一个 RayCluster。
在集群上部署 Serve 应用。
暴露 K8s Service,外部通过 /v1 访问。
监控 Serve 健康,RollingUpdate 时做 Zero-Downtime 切换。
这是 K8s 上做 Ray 推理服务部署的推荐姿势。
最后一个,也是你做 LLM 推理比较值得关注的。
假设你已经训练好了一个 Llama 模型,现在希望部署成一个在线 API 服务。
用户可以通过 HTTP 请求:POST /v1/chat/completions 向模型发送请求。
你需要:
长期运行模型实例。
对外提供 HTTP API。
多个模型副本共同处理请求。
根据请求量动态扩缩容。
模型更新时尽量不中断服务。
这就是
RayService要解决的问题。
创建 Ray 集群。
在 Ray 集群上部署模型服务。
创建 Kubernetes Service。
将 HTTP 请求转发到 Ray Serve。
6、Ray vs K8s 原生调度:何时选哪个
必须先明确:Ray 调度器与 K8s 调度器不是二选一,而是两层。它们的协作模型:
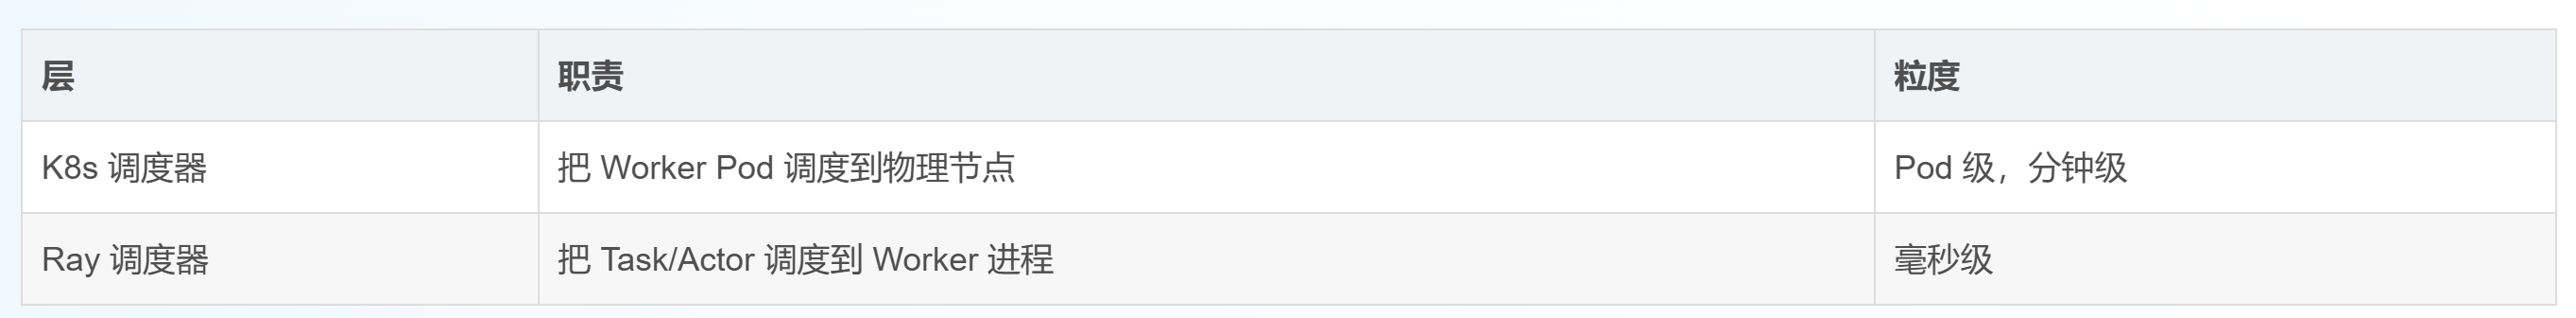
K8s 负责「粗粒度资源分配」,Ray 负责「细粒度任务调度」。Ray 的 Worker Pod 一旦起来,内部的 Task/Actor 调度就完全由 Ray Raylet 接管,K8s 不再介入。